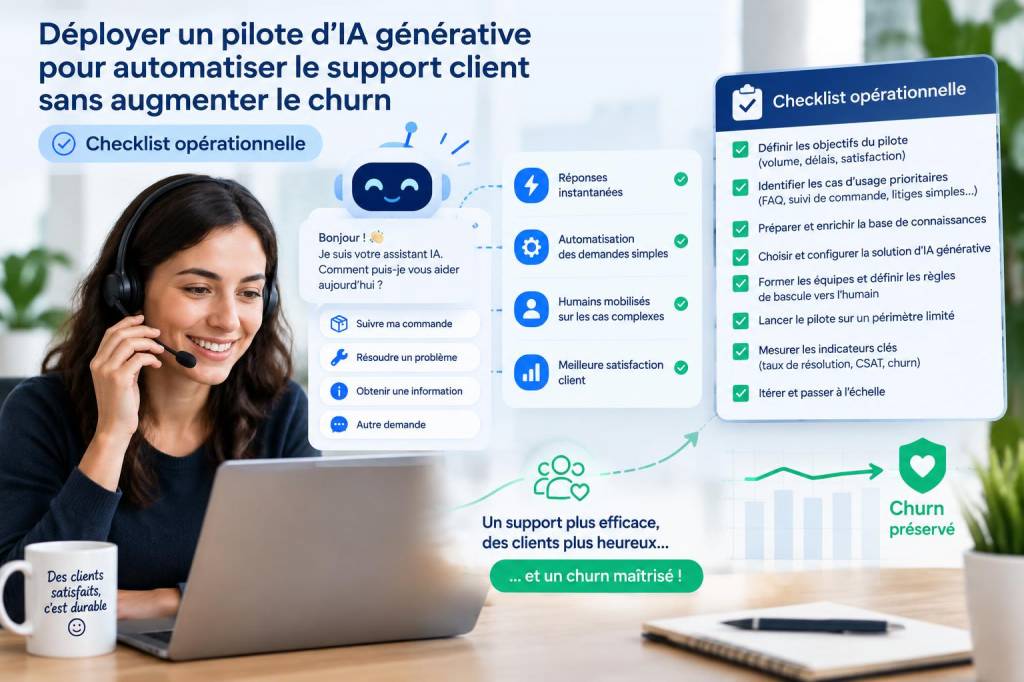
Déployer un pilote d'IA générative pour automatiser le support client peut sembler être une promesse alléchante : réduction des coûts, temps de réponse plus courts, expérience 24/7. J’ai mené plusieurs pilotes de ce type et j’ai souvent vu le même danger passer inaperçu : mal conçu, un projet d’automatisation peut mécaniquement augmenter le churn parce qu’il détériore l’expérience client ou crée des erreurs répétées. Voici une checklist opérationnelle — fondée sur des retours de terrain — pour lancer un pilote pragmatique, mesurable et sécurisant pour vos clients et vos équipes.
Définir l’objectif du pilote et les hypothèses à valider
Avant toute sélection de fournisseur ou d’API, je commence par poser deux questions simples : qu’est-ce que je veux prouver pendant le pilote ? et quelles hypothèses menacent le churn ? Les objectifs classiques : réduire le temps de première réponse, augmenter le taux de résolution au premier contact (FCR), alléger la charge des agents sur les tickets basiques. Parmi les hypothèses critiques à tester : la qualité des réponses de l’IA est suffisante, l’IA n’augmente pas le taux d’escalade inutile et l’expérience automatisée n’est pas perçue comme impersonnelle.
Je formalise ça en 3-4 metrics primaires et secondaires (voir section métriques).
Choisir le périmètre fonctionnel et les scénarios
Un pilote efficace ne couvre pas tout le support. Je recommande de démarrer sur un périmètre restreint et répétable :
Ce périmètre permet d’obtenir suffisamment de volume pour tirer des conclusions tout en limitant l’impact en cas d’erreurs.
Définir les métriques et les seuils d’alerte
Sans métriques claires, on ne sait pas si le pilote est un succès. Voici celles que j’utilise systématiquement :
Je fixe des seuils d’alerte avant le pilote. Par exemple : si le CSAT chute de >10% ou si le taux d’erreur factuelle dépasse 2%, on active le plan de mitigation.
Données, confidentialité et conformité
L’IA générative repose sur des prompts et des données historiques. J’oblige toujours l’équipe produit à répondre aux questions suivantes :
Sur des sujets sensibles (données financières, médicales), je privilégie des modèles self-hosted ou des offres avec garanties contractuelles fortes. La conformité RGPD impose aussi la traçabilité des échanges et la capacité à supprimer des données sur demande.
Conception conversationnelle et templates
Une IA performante, c’est d’abord une bonne conception conversationnelle. Je construis :
Je teste ces templates en interne avec des jeux d’exemples réels. Pour les fournisseurs, j’utilise souvent des techniques de prompt engineering et des few-shot examples pour aligner le modèle sur le style souhaité.
Human-in-the-loop : safeties et escalades
Pour éviter que l’IA ne devienne une source d’erreurs incontrôlable, je mets en place deux garde-fous :
Je mesure aussi le temps de récupération (time to resolution) pour les tickets qui ont été mal traités par l’IA et qui nécessitent une correction humaine — cela capture un coût caché du système.
SLA interne et formation des équipes
Le pilote n’est pas seulement technique : il engage les agents. J’insiste pour :
Sans adoption par les équipes, l’automatisation reste fragile et risque d’être désactivée au premier pépin.
Instrumentation et observabilité
Instrumentation = la clé. Je collecte systématiquement :
J’utilise des dashboards (Grafana, Datadog ou outils internes) et configure des alertes pour les seuils définis. Sans observabilité, on ne peut pas apprendre vite ni corriger.
Plan de mitigation et rollback
Quel que soit le soin apporté, il faut prévoir l’impensable. Mon plan inclut :
Le temps de réaction est critique pour limiter le churn. J’exige des runs d’incident dans les 30 premiers jours du pilote.
Critères de succès et voie de montée en charge
Avant toute montée en charge, j’exige que :
Si ces conditions sont remplies, la montée en charge se fait par paliers (2x, 5x volume) avec réévaluation à chaque palier.
Checklist opérationnelle synthétique
| Phase | Items clés |
| Définition | Objectifs clairs, hypothèses, KPIs & seuils d’alerte |
| Périmètre | Types de requêtes, canal unique, segment client limité |
| Données | Masking, hébergement, conformité RGPD, contrats fournisseurs |
| Conception | Templates, prompts, personnalité, exemples réels |
| Safeties | Human-in-the-loop, escalade, SLA agent |
| Instrumentation | Logging, dashboards, alertes, collecte CSAT |
| Formation | Onboarding agents, rituels de feedback, playbooks |
| Mitigation | Rollback, communication client, post-mortem |
| Montée | Critères de succès, paliers progressifs |
Un pilote d’IA générative bien mené est avant tout un projet de management du risque et d’apprentissage organisé. Si vous respectez le périmètre, instrumentez correctement et impliquez vos équipes, vous pourrez automatiser une partie du support sans sacrifier la confiance client — et même en l’améliorant quand les gains de temps se traduisent par une meilleure réactivité et des réponses plus cohérentes.